Tiempo de lectura: 18 minutos
TL;DR
En seis días de este mes, Microsoft 365 se cayó durante casi una jornada entera, la FAA paró en tierra todos los vuelos del espacio aéreo estadounidense, la red clasificada de la NSA se apagó un rato, media docena de grandes bancos de EE. UU. tropezaron, y United Airlines perdió la capacidad de decirles a sus pilotos cuánto pesaban sus aviones. Durante una semana nerviosa pareció algo coordinado. No lo fue. Cada uno de estos casos tiene una causa mundana y documentada por separado, y en todos ellos quienes investigaban no encontraron indicios de un ciberataque, y Microsoft se molestó en aclarar que tampoco hubo agentes de IA de por medio. Así que este no es un artículo del fin del mundo, porque el mundo no se acaba. Pero quiero hacer lo contrario del alarmismo y aun así dejarte algo inquieto: la razón por la que una mala semana pareció un ataque es que nuestros sistemas son ya lo bastante frágiles como para producir una semana con forma de ataque ellos solos, sin nada más exótico que un router viejo, un fallo de hace tres meses y una ventana de mantenimiento torcida. La buena noticia es que nadie nos hizo esto. La incómoda es que nadie tuvo que hacerlo.
Un apunte sobre qué es esto. Es un análisis de incidentes construido por completo sobre información pública, recopilada en los días posteriores a los hechos, con las fuentes enlazadas a lo largo del texto. Las conclusiones de causa raíz de varios de estos casos seguían siendo preliminares mientras escribía, así que donde una causa es provisional o discutida, lo digo. El objetivo es sopesar las explicaciones con honestidad, no quedarse con la más terrorífica.
Una semana, cinco fallos
Ponlos en orden, porque la secuencia es parte de por qué pareció un patrón.
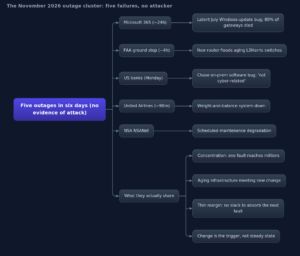
El 12 y 13 de noviembre, Microsoft 365 sufrió una caída global de casi un día. Exchange Online fue lo más golpeado, y con él se degradaron Outlook, Teams, SharePoint y Copilot. El informe preliminar de Microsoft lo atribuyó a un defecto introducido por una actualización de Windows desplegada en sus servidores de pasarela de Microsoft 365 allá por julio. Bajo carga alta, un proceso interno entró en contención de bloqueos, agotó CPU y memoria, y en dos horas más del 80 % de esos servidores de pasarela había dejado de responder. El fallo llevaba tres meses dormido, en parte porque los propios laboratorios de pruebas de Microsoft corrían sobre hardware menos potente, con menos núcleos, y nunca reprodujeron las condiciones que lo disparaban. Microsoft declaró que la caída fue «un fallo técnico, sin indicios de actividad maliciosa ni de implicación de agentes de IA».
El 13 de noviembre, horas después, la FAA emitió una orden de parada en tierra a nivel nacional. Un fallo de comunicaciones que empezó en la zona de Chicago se extendió por los centros de control de ruta, y durante más de cuatro horas cerca de 3.500 vuelos quedaron retenidos en tierra, con un efecto cascada de unas 8.000 cancelaciones y más de 10.000 retrasos. La causa provisional es de lo más anodina: durante un proyecto rutinario para sustituir cableado de cobre por fibra en una instalación remota de Arkansas, el equipo operado por L3Harris, el contratista de telecomunicaciones de la FAA, falló, y un router recién instalado, según se informó, empezó a lanzar unos mil intentos de conexión cada cuatro o cinco segundos, saturando los conmutadores más viejos y corrompiendo los datos que alimentan las pantallas de los controladores. Markwayne Mullin, de Seguridad Nacional, lo resumió como equipo nuevo saturando sistemas viejos, y dijo que no había indicios de un ciberataque ni de injerencia extranjera. La nueva herramienta de IA para control aéreo de la FAA se señaló como sospechosa y fue desmentida específicamente por la agencia y por su desarrollador.
El 16 de noviembre, varios grandes bancos de EE. UU. tambalearon. JPMorgan Chase fue el caso más claro, con la banca en línea, algunas sucursales y los pagos por Zelle interrumpidos buena parte de una tarde de lunes. Chase lo atribuyó a «un fallo de software en un sistema de hardware on-premise» y dijo sin rodeos que el problema «no está relacionado con lo cibernético». Clientes de Bank of America, Wells Fargo y otros reportaron problemas en la misma ventana, aunque algunos bancos dijeron que sus propios sistemas estaban bien.
También el 16 de noviembre, United Airlines sufrió una caída de sistemas de unos 90 minutos que le impidió generar las cifras finales de peso y centrado, los números que una tripulación necesita antes de despegar. Un comunicado sindical lo dijo claro: «La compañía no puede proporcionar pesos finales a los vuelos de salida». United dijo que no había indicios de que la caída estuviera relacionada con un problema de ciberseguridad.
Y a lo largo de mediados de noviembre, la red interna clasificada de la NSA, NSANet, sufrió lo que la agencia llamó «una degradación temporal durante un mantenimiento programado rutinario», añadiendo que las capacidades críticas de la misión siguieron en pie. CNN, citando a seis fuentes, informó de que no había indicios de que la interrupción viniera de un ciberataque.
Cinco sistemas, cinco operadores muy distintos, seis días. Se entiende por qué la gente empezó a trazar líneas entre los puntos.
Las explicaciones a las que recurrimos
Cuando muchas cosas se rompen a la vez, la mente quiere una sola causa. Déjame tomar los candidatos de uno en uno, incluidos los que dan miedo, y sopesar cada uno por la evidencia y no por la sensación.
¿Fue un ataque coordinado, o un Estado? Es el primer sitio al que va la cabeza de alguien de seguridad, y es el que la evidencia rechaza con más claridad. En cada incidente, los investigadores que lo sabrían dijeron que no había señal de ello: Mullin en la FAA, Chase en los bancos, United en su caída, las fuentes de CNN en la NSA, y Microsoft en lo suyo. Ningún actor ha reivindicado nada, no ha aflorado ninguna intrusión común, y las causas que sí han aflorado son internas y específicas de cada operador. ¿Podría un informe forense posterior cambiar alguno de estos relatos? Sí, y no me jugaría la casa a que todas estas historias están contadas del todo. Pero «cinco organizaciones no relacionadas fueron comprometidas en silencio la misma semana y todas resultaron tener además un fallo interno plausible al que señalar» es una afirmación mucho más pesada de lo que la evidencia sostiene ahora mismo, y las afirmaciones extraordinarias necesitan más que un calendario inquietante.
¿Fueron agentes de IA? Esta merece atención de verdad en vez de un descarte reflejo, porque es mi terreno y porque, de forma reveladora, las autoridades tuvieron que abordarla directamente. He pasado el año documentando que los frameworks de ataque autónomos se ejecutan ya a escala por el precio de un café por intento, así que una causa agéntica ya no es una pregunta tonta, y el hecho de que Microsoft dijera de forma preventiva «sin implicación de agentes de IA» y de que la FAA tuviera que negar que su propia herramienta de IA causara la parada en tierra te dice cuánto se ha movido la ventana de Overton en un año. Pero pasa de la novedad y la evidencia apunta al otro lado. Un agente atacando a escala deja rastro, la velocidad y la amplitud sobre las que no dejo de escribir, y aquí no se ha reportado nada de eso. Lo que comparten estos incidentes no es un adversario astuto, sino un modo de fallo tonto, y un fallo latente de Windows de julio no es un agente. La lectura honesta es que la pregunta por los agentes de IA ya es lo bastante razonable como para hacerla, lo cual es genuinamente nuevo, pero la respuesta esta semana es no.
¿Fue hardware y software obsoleto? Aquí la evidencia sí dice que sí, y más alto en la FAA. Sus propios responsables describieron equipo nuevo saturando sistemas viejos, y la parada en tierra se asienta sobre una infraestructura de control aéreo que lleva años descrita como envejecida, que es justo por lo que el Secretario de Transporte estaba ante el Congreso pidiendo decenas de miles de millones para reemplazarla. La infraestructura envejecida no suele fallar en un día tranquilo; falla cuando la tocas, y por eso una mejora de fibra y un router nuevo bastaron para tumbar el espacio aéreo de un país.
¿Fue un cambio precipitado o mal gestionado? Este es el hilo que me parece más convincente del conjunto, y es el corazón profesional de la historia. Casi todos estos casos se remontan no al sistema en estado estable, sino a un cambio hecho sobre él: una actualización de Windows en julio, un cambio de red y un router nuevo en la FAA, un fallo de software en el sistema on-premise de un banco, una ventana de mantenimiento en la NSA. Esto no es del todo la caricatura del «mal vibe-coding» de una IA escribiendo código chapucero, aunque ese riesgo es real y va a más. Es el fallo más viejo y más aburrido de la gestión del cambio y las pruebas. El fallo de Microsoft es la parábola perfecta: el defecto fue real durante tres meses y nadie lo vio porque el entorno de pruebas era más flojo que el de producción y nunca recreó la carga que lo activaba. Esa es una historia de laguna en las pruebas, y es la lección más repetible de todas.
¿Fue simple coincidencia? En parte sí, y sería deshonesto fingir lo contrario. Las tasas base importan: los sistemas grandes fallan constantemente, y en una semana cualquiera algo en algún sitio está roto. Lo que cambió esta semana no fue solo el número de fallos, sino nuestra atención sobre ellos. Una vez que las caídas de Microsoft y la FAA abrieron los informativos, cada incidencia posterior se contó sobre ese fondo y se archivó mentalmente bajo la misma historia, una ilusión de agrupamiento ayudada por una relevancia genuinamente aumentada. La propia reacción del presidente a la caída de la NSA, «cosas así pasan», es desdeñosa pero no está equivocada como estadística de tasa base. Parte del patrón aparente es fragilidad real; parte es que nos fijamos.
¿Hubo un factor desconocido? En al menos un caso, con honestidad, todavía no lo sabemos del todo. El propio administrador de la FAA dijo que la explicación de L3Harris «no servía como explicación completa de la causa raíz», y una asesora de ciberseguridad cuestionó en público si el «fallo de software» de Chase era toda la historia. La honestidad intelectual obliga a dejar eso abierto. No todos estos expedientes están cerrados, y un análisis responsable deja sitio a que un informe posterior complique la versión ordenada. Mientras salía este artículo, la historia de la FAA iba justo en esa dirección: los investigadores habían reproducido en pruebas la saturación de la red, pero el hilo que emergía era menos un único router defectuoso y más uno institucional, con informaciones de que el trabajo de mejora del contratista había avanzado con poca supervisión y de que a la FAA se le había advertido de antemano sobre la mejora de telecomunicaciones. No es una explicación más ordenada, pero sí reveladora, porque apunta directamente a la gestión del cambio y la supervisión, no lejos de ellas.
Ya hemos estado aquí
Si esta semana pareció sin precedentes, no lo fue, y los precedentes son la mejor prueba de la explicación aburrida. En julio de 2024, una sola actualización defectuosa del sensor Falcon de CrowdStrike, un único fichero de configuración malo, dejó con el pantallazo azul a unos 8,5 millones de máquinas Windows en cuestión de horas y se convirtió en la mayor caída informática de la historia: más de diez mil vuelos retrasados o cancelados, bancos y hospitales e incluso algunos servicios de emergencias 911 caídos, cadenas de televisión fuera del aire. No fue un ataque, y tanto CISA como CrowdStrike lo confirmaron. Un proveedor, un cambio, una parada global.
Y los doce meses previos a este grupo fueron un redoble de la misma forma. Un fallo de DNS en una sola región de AWS tumbó una buena parte de internet durante más de quince horas. Un cambio de configuración defectuoso en Azure Front Door tiró abajo los propios servicios de Microsoft y las aplicaciones que viajan sobre ellos. Cloudflare dejó fuera a unos tres millones de sitios cuando un cambio de permisos en una base de datos duplicó el tamaño de un fichero interno. Cada uno de esos casos fue un fallo de configuración o de software, y ninguno fue un ciberataque. Pon el grupo de noviembre al lado de esa racha y deja de parecer una semana oscura y empieza a parecer el clima normal de un sistema concentrado y de cambio rápido. La historia de la caída moderna no es el hacker. Es el cambio que salió mal en un sitio del que depende demasiado.
Lo que de verdad los conecta
Así que si no fue un atacante, ¿cuál es el hilo compartido?, porque lo hay, y fingir que son cinco sucesos del todo aleatorios se pierde la lección real.
La conexión es estructural, no adversarial. Cuatro cosas aparecen una y otra vez a lo largo de la semana. Hay concentración: una sola capa de pasarela de Microsoft, un solo contratista de telecomunicaciones, un puñado de bancos sobre raíles compartidos, de modo que un único fallo interno irradia hacia millones. Hay infraestructura envejecida que se encuentra con tecnología nueva, lo más visible en la FAA, donde el propio acto de modernizar el sistema viejo es lo que lo rompió. Hay margen escaso: la caída de Microsoft empeoró porque el 14 % de la capacidad relevante ya estaba fuera por un problema no relacionado del día anterior, así que no había holgura para absorber el siguiente problema. Y está el cambio como detonante, el detalle recurrente de que casi ninguno de estos falló mientras estaba quieto; fallaron cuando alguien los actualizó, parcheó, migró o mantuvo. Ninguna de esas cuatro cosas es un hacker. Las cuatro son las condiciones que vuelven frágil a un sistema, y un sistema frágil no necesita un atacante para tener una semana malísima.
Por qué esto importa igual, aunque no fuera un ataque
Aquí está la parte que más quiero que se lleve un defensor, y es la razón por la que un blog de seguridad escribe siquiera sobre caídas. Un sistema resiliente y un sistema seguro se construyen con los mismos materiales. Los controles que contienen un ciberataque, los límites de radio de impacto, el aislamiento, la degradación elegante, el rollback probado, una gestión del cambio de verdad, conocer tus dependencias, son exactamente los controles que habrían suavizado cada incidente de esta semana. Que lo que tumbe tu servicio sea un operador ruso, un agente autónomo o un fallo de tres meses en una actualización de Windows, la ingeniería que te salva es idéntica. Eso es una buena noticia curiosa, porque significa que no tienes que adivinar la amenaza para prepararte. Te blindas contra el fallo, y el ataque es solo un tipo de fallo.
Y hay un punto de futuro con el que vale la pena quedarse, sin sobrevenderlo. La razón por la que esta semana se preguntó «¿fueron agentes de IA?», por periodistas y por las propias empresas, es que ha dejado de ser una pregunta ridícula. Entramos en una época en la que el fallo mundano y el ataque agéntico pueden producir un mal día de aspecto parecido, y distinguirlos rápido será en sí mismo una habilidad defensiva, algo que ya he sostenido que forma parte del oficio. Esta semana la respuesta fue la aburrida. No siempre lo será, y las organizaciones que puedan ver la diferencia rápido, porque tienen los registros, las líneas base y los mapas de dependencias para mirar de verdad, son las que no tendrán que adivinar.
Qué hacer el lunes
Tres movimientos, ninguno sobre un enemigo concreto, porque la gracia es que no necesitas conocer la causa para estar preparado.
Sabe qué puede alcanzar un solo fallo. Mapea tus dependencias reales, el proveedor, la pasarela, el contratista, el raíl compartido, y encuentra los fallos únicos que irradian hacia todo lo que ejecutas. No puedes reducir un radio de impacto que nunca has dibujado, y buena parte de esta semana fue un fallo interno llegando mucho más lejos de lo que nadie había mapeado.
Trata cada cambio como la causa más probable, porque lo es. Escalónalo, pruébalo con una carga parecida a la de producción y no en un laboratorio más flojo, despliégalo de forma gradual, y mantén un rollback que de verdad funcione, recordando la lección de Microsoft de que un cambio desplegado hace tres meses ya no se deshace sin más. Casi nada de esta semana se rompió estando quieto; se rompió cuando alguien lo tocó.
Ensaya fallar pequeño. Construye y ejercita de verdad la degradación elegante, el aislamiento y los repliegues manuales, para que cuando un sistema se caiga se lleve una función y no todo el servicio, y una mala tarde siga siendo una tarde. Da por hecho que la caída llega y decide ahora cuánto se le permite llevarse.
Y ahora qué
Cinco sistemas se rompieron en una semana y no fue una conspiración, fue un fallo latente, un router saturado, una ventana de mantenimiento, un fallo de software on-premise y un sistema de peso y centrado, cada uno aburrido, cada uno explicado por separado, y en ningún caso un ataque confirmado. Resiste el instinto de tejerlos en un único relato dramático, porque los hechos no lo sostienen y el pánico no ayuda. Pero resiste también el instinto contrario, el encogimiento de hombros que dice que son solo fallos y que no pasa nada. Pasa algo, y es más estructural y menos cinematográfico que un enemigo: hemos construido sistemas críticos con demasiada concentración, demasiada poca holgura, demasiada infraestructura envejecida bajo demasiado cambio nuevo, y demasiado poca disciplina de pruebas y resiliencia como para cazar un problema antes de que pasen tres meses y el ochenta por ciento de tus servidores. El arreglo no es un muro más alto contra un villano. Es el trabajo sin glamour de hacer sistemas que fallen pequeño, fallen seguro y fallen a la vista, para que la próxima mala semana, la cause lo que la cause, siga siendo una mala semana y no un titular.
Mantén la calma, desconfía de los relatos ordenados en ambas direcciones, y construye cosas que se doblen en vez de romperse.
- X (Twitter): @SimonRoses
Lecturas recomendadas:
- Forbes: Microsoft pide disculpas por la caída de 365 y revela la causa
- Malwarebytes: la caída global de Microsoft 365 interrumpe Outlook, SharePoint y Teams
- CBS News: la FAA levanta la parada en tierra nacional; la Casa Blanca dice que no hay indicios de un «acto malicioso»
- Reuters: la FAA emite una parada en tierra nacional por una «circunstancia extraordinaria»
- Al Jazeera: la caída de la banca de EE. UU., qué causó los problemas de Chase y los retrasos de Zelle
- BBC: grandes bancos afectados por problemas informáticos
- CBS News: United Airlines resuelve una caída de sistemas generalizada que afectó a los vuelos de salida
- Reuters: United Airlines dice que un problema tecnológico afectó a los vuelos de salida
- Al Jazeera: la NSA atribuye la caída de su red clasificada a un mantenimiento rutinario
- BBC: caída de la red clasificada de la NSA
- TechTarget: la mayor caída informática de la historia explicada (CrowdStrike, julio de 2024)
- El mes en que la IA se cambió de bando: octubre de 2026 en seguridad
- ¿Quién cobra cuando la máquina hace el trabajo?
¿Preguntas o comentarios? Contacta a través de:
- Web: vulnex.com
- Estrategia de Seguridad en IA: vulnex.ai
- Twitter/X: @SimonRoses
- LinkedIn: linkedin.com/in/simonroses
- GitHub: github.com/vulnex
Contacto: info@vulnex.com


